

Wypróbuj Weglot za darmo



Twoja strona jest przetłumaczona. Google wyświetla Twoje francuskie strony, ruch na stronie wygląda normalnie, a Search Console nie zgłasza żadnych zastrzeżeń. Nagle ktoś z Paryża prosi ChatGPT o rekomendację w Twojej kategorii, a Ciebie nie ma w odpowiedzi.
Zajmuję się audytowaniem stron wielojęzycznych i ta kwestia pojawia się na tyle często, że postanowiłem to zbadać. We wrześniu 2026 roku przetestowałem 97 stron wielojęzycznych i 174 wersje językowe, aby sprawdzić, jakie dane otrzymuje robot indeksujący asystenta AI, gdy prosi o przetłumaczoną stronę.
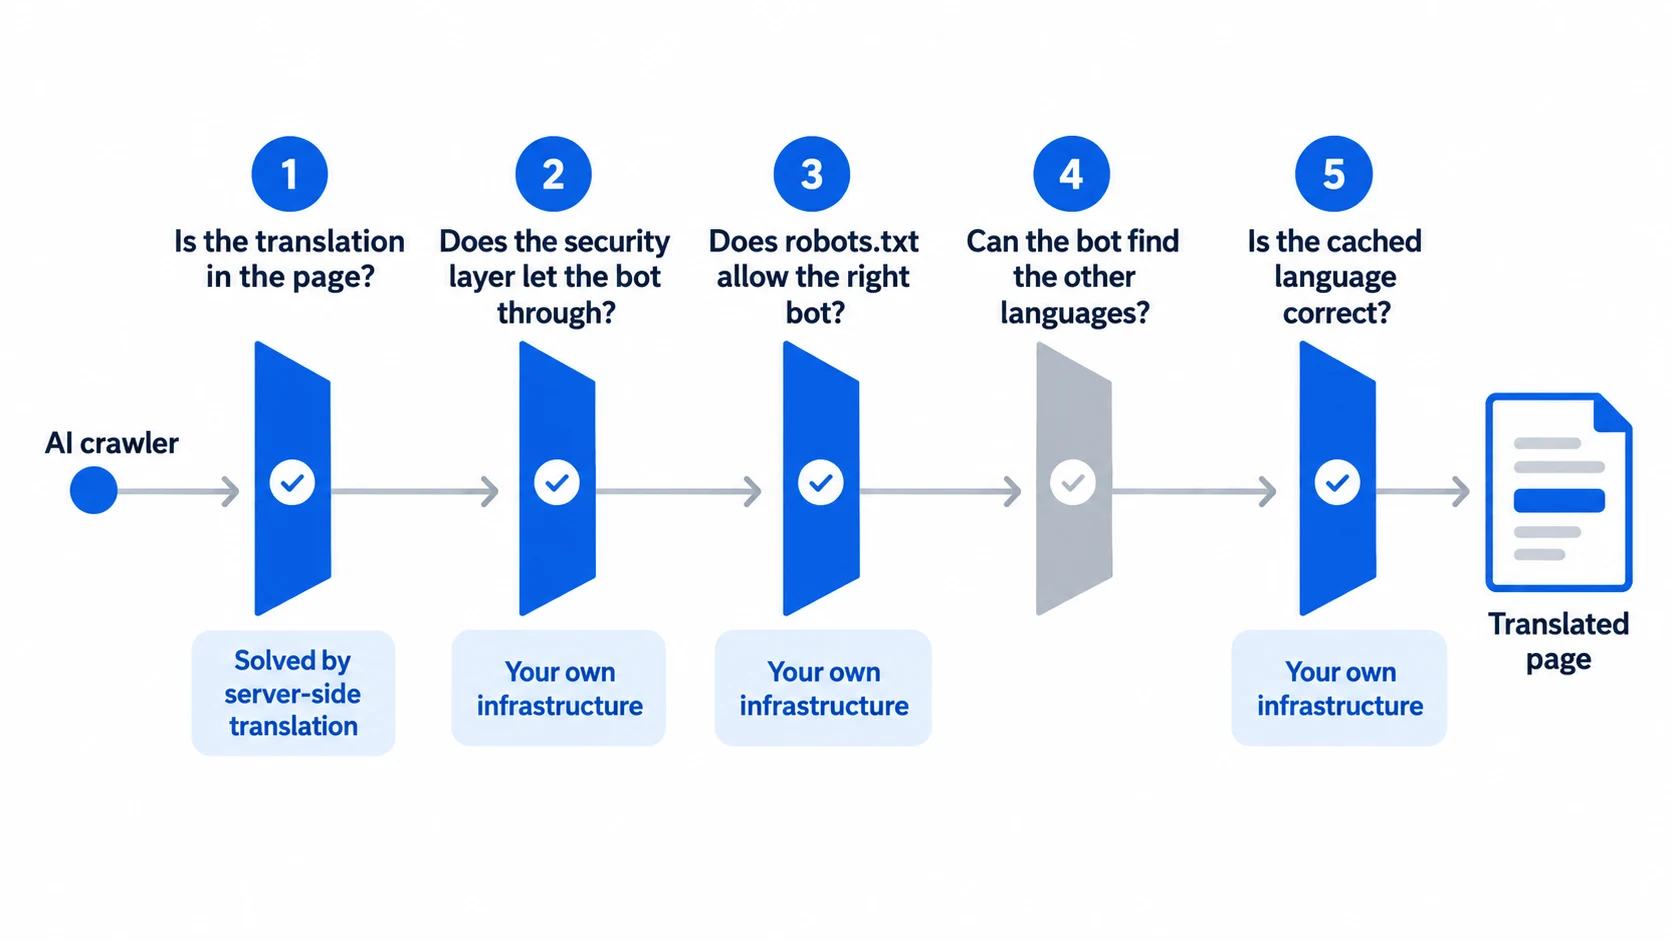
Zauważyłem problemy na 5 różnych poziomach. Niektóre z najpoważniejszych niepowodzeń w moim badaniu dotyczyły obiektów, które przeszły pomyślnie pierwszy poziom.
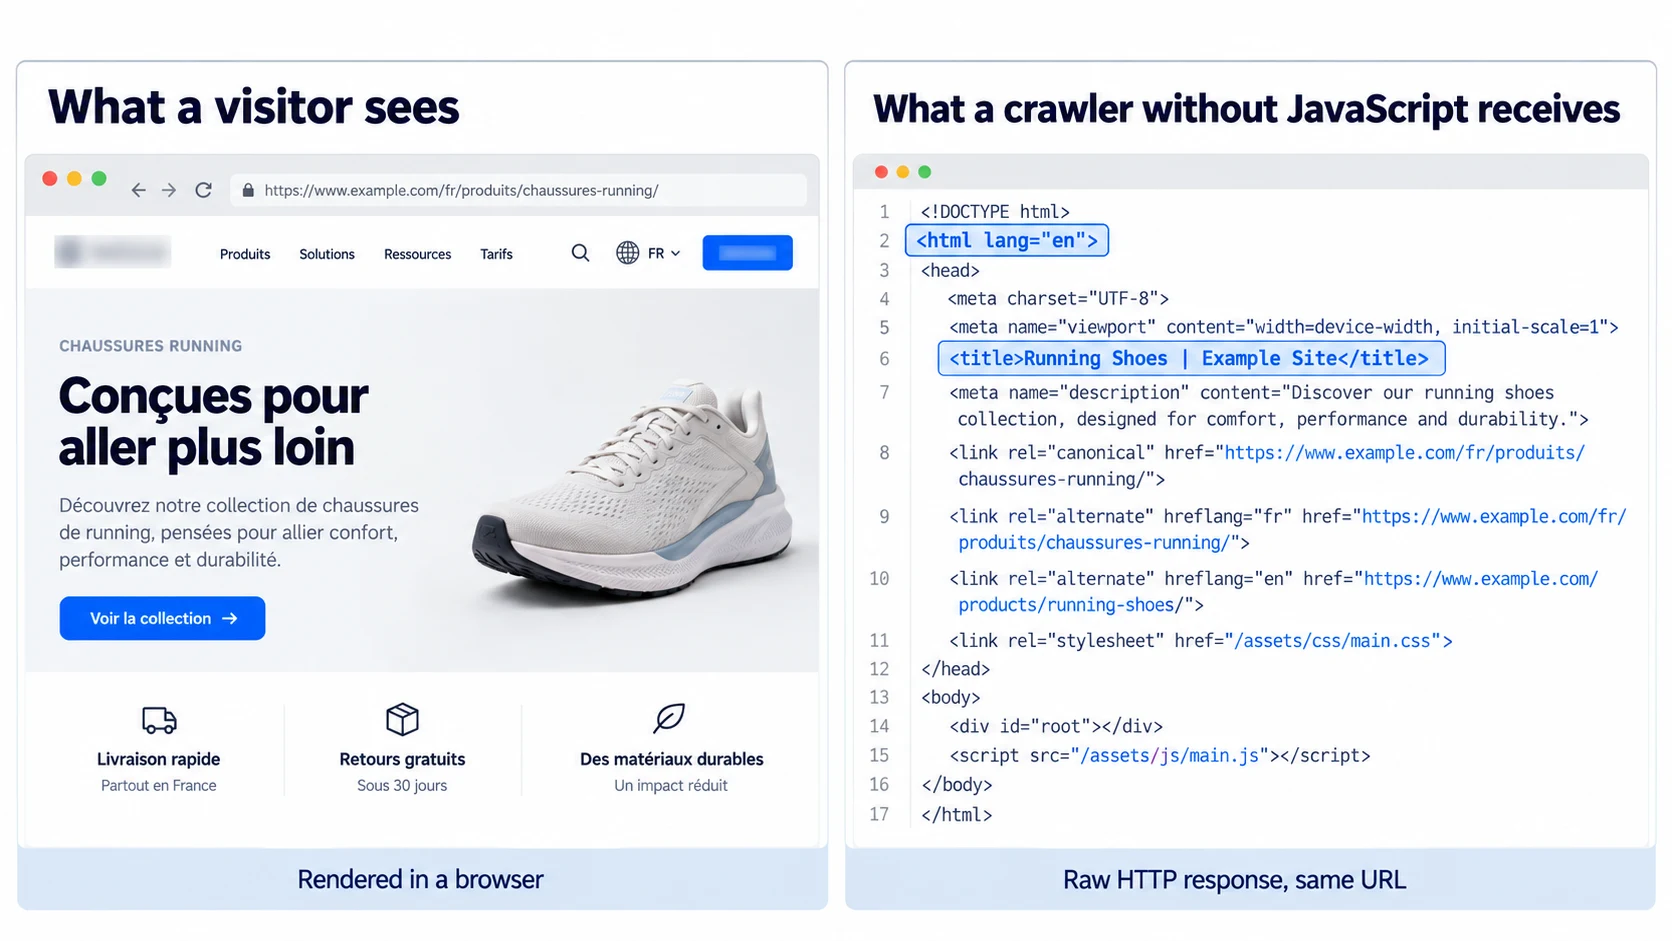
Kiedy otwierasz stronę, przeglądarka wykonuje dwa zadania. Najpierw pobiera stronę przesłaną przez serwer, a następnie uruchamia skrypty, które kończą tworzenie tego, co widzisz.
Google, Bing i Apple twierdzą, że ich roboty indeksujące uruchamiają skrypty. Pozostałe podmioty, w tym boty obsługujące ChatGPT, Claude i Perplexity, nie wypowiadają się w tej sprawie, a głównym publicznie dostępnym dowodem jest jedno badanie z grudnia 2024 r., obejmujące zaledwie 3 strony internetowe.
W przypadku pozostałych robotów indeksujących opartych na sztucznej inteligencji nie ma więc oficjalnej odpowiedzi. Nawet Bing, którego robot indeksujący uruchamia skrypty, zaleca właścicielom stron, aby unikali „ukrywania kluczowych treści za renderowaniem po stronie klienta”. Warto stosować się do tej rady, dopóki inne firmy zajmujące się sztuczną inteligencją nie wyjaśnią, jak działają ich roboty indeksujące.
Istnieją dwa sposoby tłumaczenia strony internetowej. Albo serwer wysyła stronę już w języku francuskim, albo wysyła stronę w języku angielskim, a skrypt zamienia słowa po tym, jak strona dotrze do przeglądarki.
Dla odwiedzającego obie strony wyglądają tak samo. Jednak robot indeksujący, który nie uruchamia skryptów, widzi zawsze tylko tę pierwszą.
Test ten można łatwo przeprowadzić samodzielnie; nie wymaga żadnych narzędzi i zajmuje 10 sekund. Otwórz stronę w języku francuskim, kliknij prawym przyciskiem myszy i wybierz opcję „Wyświetl kod źródłowy strony”. Jeśli tekst w języku francuskim nie znajduje się w kodzie źródłowym, robot indeksujący, który nie uruchamia skryptów, również go nie zobaczy.
Te dane mnie zaskoczyły. Mediana stron, które przeanalizowałem, udostępnia już 84,6% treści tekstowej bez skryptów, więc twierdzenie, że wielojęzyczne strony internetowe są pustymi skorupami, nie ma uzasadnienia. Najpoważniejsze przypadki są natomiast skoncentrowane: około 1 na 7 stron udostępnia mniej niż 30% treści tekstowej, a serwisy e-commerce i turystyczne wypadły znacznie gorzej niż strony poświęcone oprogramowaniu, mediom czy instytucjom.
W przypadku konfiguracji domen pod Weglot, katalogów podrzędnych oraz WordPress tłumaczenie odbywa się na serwerze, więc jest zapisywane w kodzie źródłowym strony, zanim trafi ona do użytkownika. W WordPressie oznacza to, że adresy URL z oznaczeniem języka, takie jak /fr/about/, zwracają przetłumaczoną treść bez tworzenia dodatkowych stron w panelu administracyjnym.
Wyjątkiem jest integracja JavaScript serwisu Weglot, która jest przeznaczona do niestandardowych konfiguracji i wiąże się z udokumentowanym kompromisem: tłumaczenia te nie znajdują się w kodzie źródłowym strony. Jeśli zależy Ci na widoczności dla sztucznej inteligencji, najlepszym rozwiązaniem będzie subdomena, podkatalog lub integracja z systemem CMS.
W celach porównawczych sprawdziłem francuską stronę główną serwisu weglot.com: przed uruchomieniem jakiegokolwiek skryptu zawierała ona 97,6% tekstu oraz 17 tagów hreflang.
Jeśli Twoja strona działa za pośrednictwem sieci dostarczania treści (CDN) lub usługi zabezpieczającej, takiej jak Cloudflare, usługa ta sprawdza każde żądanie, zanim dotrze ono do Twojego serwera, i może zablokować każdego odwiedzającego, którego uzna za zagrożenie, w tym boty. Chroni ona stronę przed atakami i przyspiesza jej działanie, ale decyduje również, których odwiedzających należy odrzucić.
W moim badaniu 11,6% testowanych przeze mnie witryn wyświetlało robotowi indeksującemu Google’a normalną stronę, a robotom opartym na sztucznej inteligencji zwracało komunikat o błędzie – różniły się one jedynie nazwą bota. W 9 z tych 11 przypadków plik robots.txt witryny – publiczny plik, w którym określa się, jakie treści mogą odczytywać boty – zezwalał właśnie na dostęp tego robota indeksującego, którego usługa bezpieczeństwa blokowała. 8 z 11 witryn to instytucje publiczne, uniwersytety lub organizacje turystyczne – podmioty, które zazwyczaj chcą, aby ich treści były odczytywane.
Twój system CMS, Search Console i narzędzia analityczne nie wykryją żadnego z tych problemów, ponieważ strona ładuje się normalnie zarówno dla Ciebie, jak i dla Google.
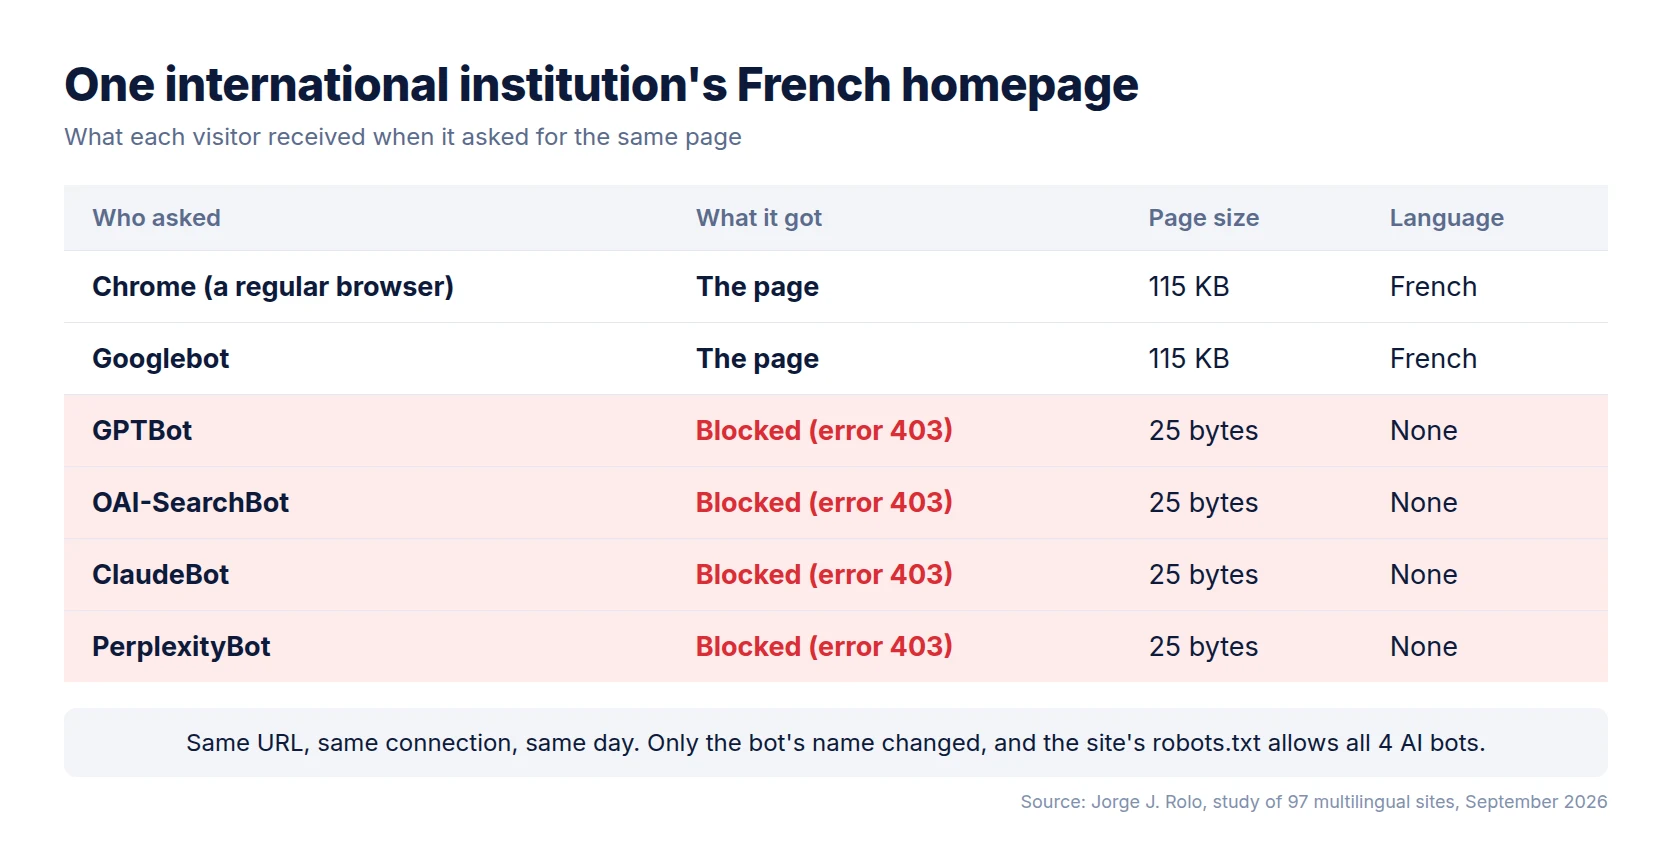
Każda firma zajmująca się sztuczną inteligencją korzysta z kilku botów przeznaczonych do różnych zadań. OpenAI opisuje GPTBot jako narzędzie do szkolenia oraz OAI-SearchBot jako narzędzie do wyszukiwania.
Zablokowanie GPTBot sprawia, że Twoje treści nie zostaną wykorzystane do przyszłego szkolenia modelu, ale nie powoduje to usunięcia ich z wyników wyszukiwania w ChatGPT. Zablokowanie OAI-SearchBot to umożliwia, więc sprawdź, który z tych dwóch botów jest wymieniony w pliku robots.txt.
W mojej próbie 27,7% stron wymieniło w pliku robots.txt co najmniej jednego bota opartego na sztucznej inteligencji, a 11,7% zablokowało co najmniej jednego na swoich stronach językowych, przy czym żadna strona nie zablokowała Google ani Bing.
Twoja strona w języku francuskim może być idealna, a mimo to pozostawać niedostępna, ponieważ robot indeksujący musi ją najpierw znaleźć, co robi, podążając za linkami zawartymi w kodzie źródłowym strony.
W przypadku 42,4% sprawdzonych przeze mnie wersji językowych jedyną drogą prowadzącą ze strony oryginalnej do strony przetłumaczonej był tag hreflang – czyli tag informujący wyszukiwarki, która strona jest francuską wersją której. Nie było tam żadnego zwykłego linku, ponieważ menu językowe jest oparte na skrypcie.
Witryny te działają obecnie, ponieważ tagi hreflang znajdują się w kodzie źródłowym strony. Jeśli jednak przeniesie się je do skryptu – tak jak robią to niektóre wtyczki tłumaczeniowe, dodając menu językowe – strony te tracą jedyną ścieżkę, którą robot indeksujący może podążać, aby do nich dotrzeć. W moim przykładzie dotyczyło to 4 z 10 przetłumaczonych stron.
Weglot automatycznie dodaje te tagi do stron, bez konieczności ingerencji w kod. W dokumentacji dotyczącej SEO wyjaśniono, jak to działa w przypadku każdego rodzaju konfiguracji.
Niektóre strony wybierają język na podstawie ustawień przesłanych przez przeglądarkę. Rozwiązanie to sprawdza się, o ile strona zawiera również krótką informację o treści: „Ta strona zmienia się w zależności od języka użytkownika”.
Bez tego kopia zapisana w celu przyspieszenia działania może zostać przekazana kolejnemu użytkownikowi niezależnie od jego języka. 10 stron z mojej próby dostosowywało zawartość strony do języka użytkownika, przy czym tylko jedna z nich wyraźnie o tym informowała.
Wykonaj te czynności po kolei: każdy krok zadziała dopiero po pomyślnym zakończeniu poprzedniego.
Funkcja „Sprawdzanie adresów URL” w Search Console pokazuje stronę wyświetlaną przez Google, a Google uruchamia skrypty, więc strona przetłumaczona za pomocą skryptów wygląda tam na idealnie przetłumaczoną. Nie jest w stanie wykryć tego problemu – właśnie dlatego istnieje metoda sprawdzania nr 1.
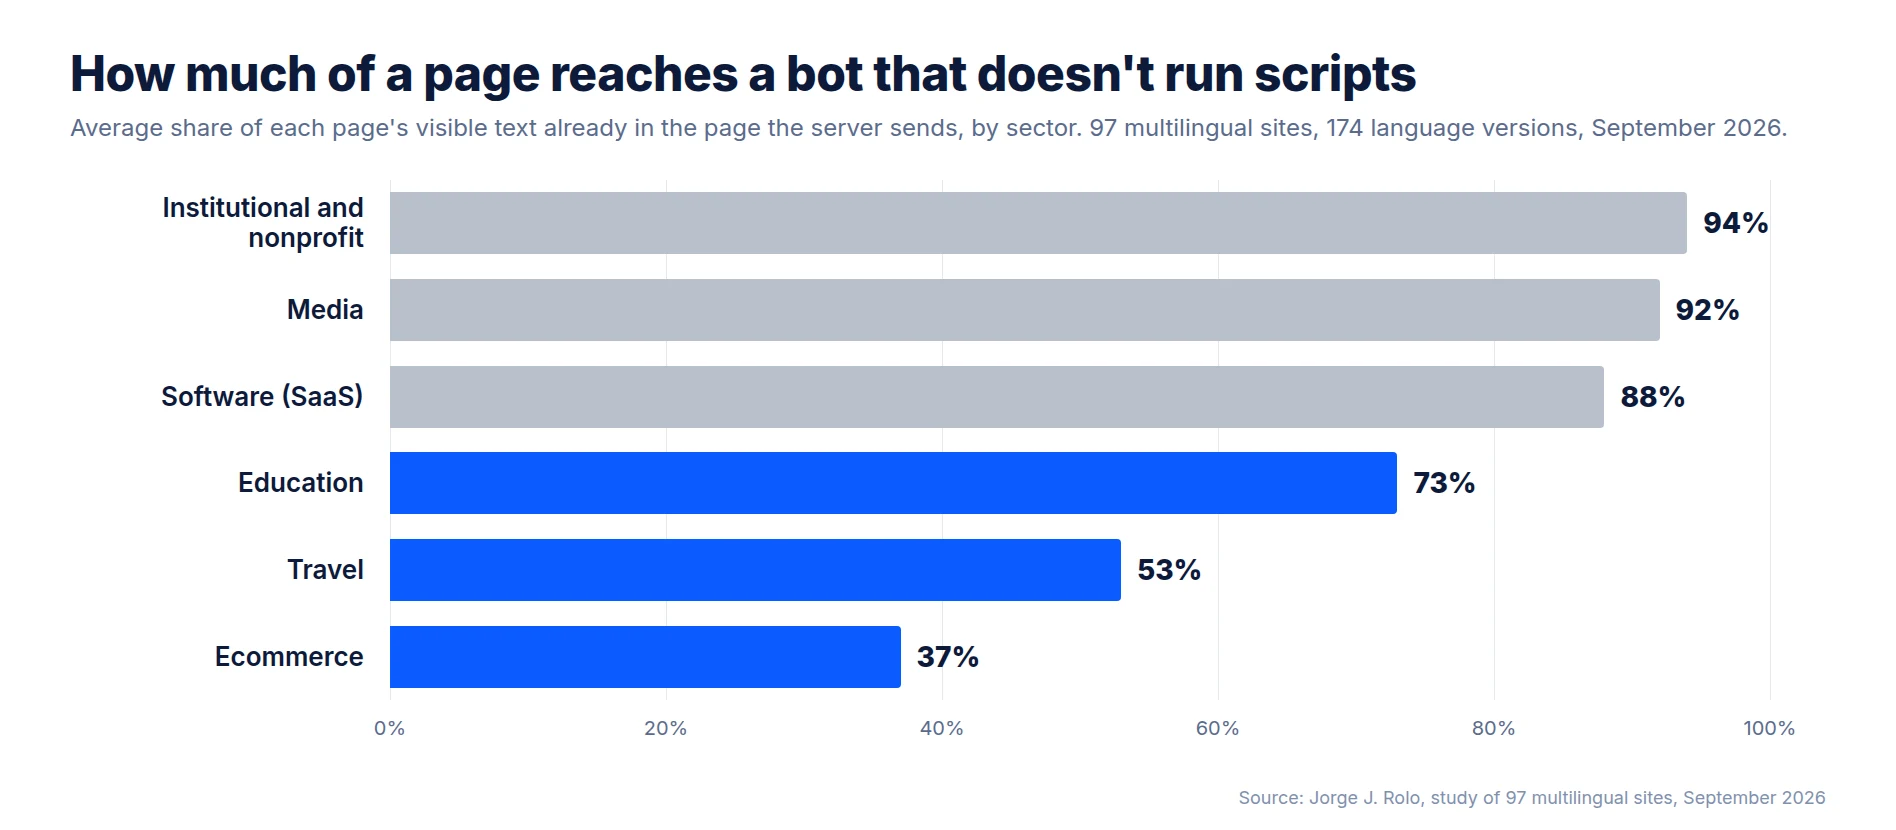
Przeanalizowałem 97 wielojęzycznych stron internetowych i 174 wersje językowe, obejmujące serwisy z branży oprogramowania, turystyki, handlu elektronicznego, mediów, edukacji, instytucji oraz organizacji non-profit.
W przypadku każdej witryny wysłałem żądanie do każdej strony dwukrotnie: raz jako przeglądarka obsługująca skrypty, a raz jako bot, który ich nie obsługuje. Następnie wysłałem to samo żądanie pod 6 różnymi nazwami robotów indeksujących i sprawdziłem reguły pliku robots.txt każdej witryny pod kątem ścieżek językowych. Aby uniknąć stronniczości, przed przetestowaniem każdej witryny, której jeszcze nie znałem, zapisałem i opatrzyłem datą i godziną sposób, w jaki ją sklasyfikowałem.
Badanie ma dwa ograniczenia. Moje zapytania wysyłałem ze zwykłego połączenia internetowego, a nie z serwerów samych firm zajmujących się sztuczną inteligencją, więc zmierzyłem to, co otrzymuje bot nazywający się GPTBot, co może różnić się od tego, co otrzymuje prawdziwy GPTBot. Zmierzyłem również to, co otrzymują roboty indeksujące, a nie to, jak często asystenci AI powołują się na te strony. To wymagałoby osobnego badania.
Jeśli w tym tygodniu masz zrobić tylko jedną rzecz, sprawdź kod źródłowy swojej najważniejszej przetłumaczonej strony. Jeśli nie ma tam przetłumaczonego tekstu, to właśnie znalazłeś odpowiedź – rozwiązaniem jest wyświetlanie tłumaczeń z serwera, a nie z przeglądarki.
Jeśli tam jest, przejdź do warstwy 2, bo właśnie tam znalazłem błędy, które umykają standardowym kontrolom.
To, że tekst został przetłumaczony, a to, że jest czytelny, to nie to samo, ale różnicę między nimi można zmierzyć w ciągu jednego popołudnia.
Upewnij się, że roboty indeksujące oparte na sztucznej inteligencji mogą odczytać każdy język, w którym publikujesz treści. W moim badaniu około 1 na 7 przetłumaczonych stron dostarczała mniej niż 30% swojego tekstu robotom indeksującym, które nie obsługują skryptów. Dzięki konfiguracjom subdomen, podkatalogów i WordPressa oferowanym przez WeglotTwoje tłumaczenia są dostarczane z serwera, a tagi hreflang są dodawane automatycznie, dzięki czemu każdy język znajduje się w kodzie źródłowym strony już od pierwszego żądania. Rozpocznij 14-dniowy bezpłatny okres próbny, a następnie przeprowadź test nr 1 na swoich własnych przetłumaczonych stronach.

Uruchomimy dla Ciebie pierwsze języki. Ty decydujesz, jak daleko chcesz się posunąć. Wypróbuj Weglot za darmo już dziś.
Cieszy się zaufaniem ponad 110 000 marek z całego świata



Od 2016 roku Weglot zaufaniem marek na całym świecie, które przetestowały tę platformę. Dołącz do nich już dziś.


Najlepszym sposobem, by zrozumieć możliwości serwisu Weglot , jest przekonanie się o tym na własne oczy. Wypróbuj go za darmo i bez żadnych zobowiązań.
Jeśli nie jesteś jeszcze gotowy, by podłączyć swoją stronę internetową, w panelu użytkownika dostępna jest strona demonstracyjna.


