

免费试用 Weglot



您的网站已经过翻译。谷歌显示了您的法语页面,流量看起来很正常,搜索控制台也没有任何异常提示。然而,当巴黎的某位用户向ChatGPT咨询您所在类别的推荐时,您的网站却没有出现在答案中。
我以审核多语言网站为生,由于这种情况经常出现,所以我决定对此进行一番研究。2026年9月,我测试了97个多语言网站和174个语言版本,以了解当AI助手请求获取翻译后的页面时,其爬虫会收到什么内容。
我在5个不同的层面上发现了问题。在我研究中,一些最严重的失误竟来自那些通过了第一层测试的站点。
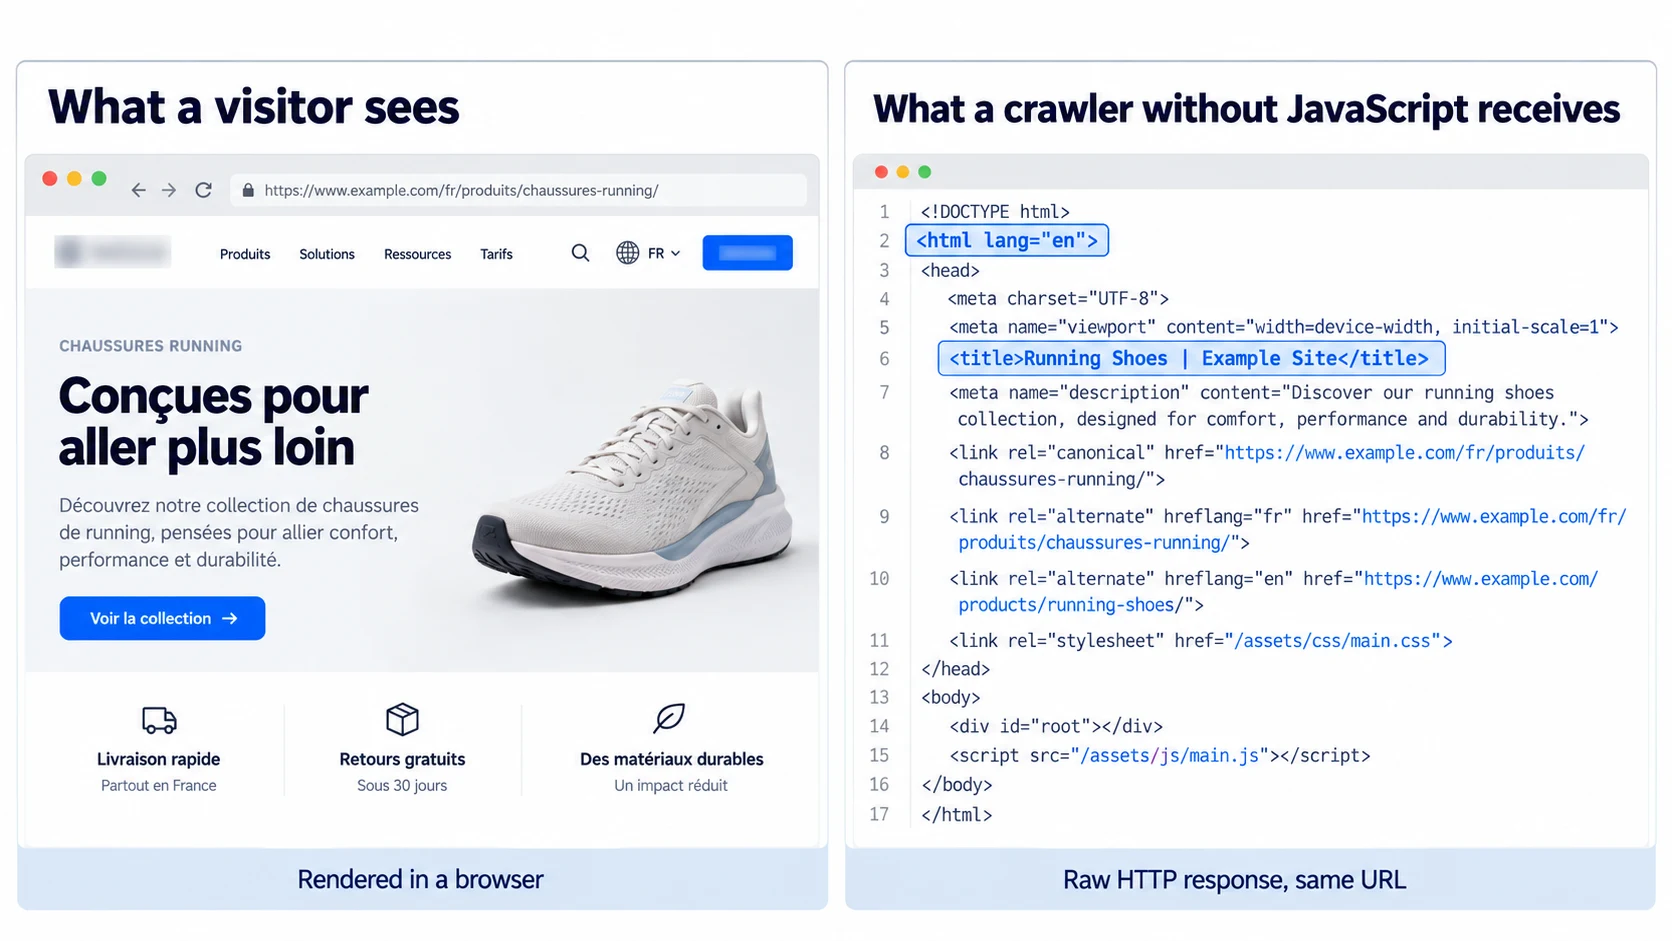
当您打开一个网页时,浏览器会执行两项任务:首先下载服务器发送的网页,然后运行脚本以完成您所看到内容的渲染。
谷歌、必应 和苹果表示,其爬虫会运行脚本。其余公司——包括ChatGPT、Claude和Perplexity背后的机器人——对此既未确认也未否认,而目前公开的主要证据仅是一项发表于2024年12月的研究,该研究仅涵盖了3个网站。
因此,对于其他人工智能爬虫,目前尚无官方答案。就连其爬虫确实会运行脚本的必应(Bing),也建议网站所有者避免“将关键内容隐藏在客户端渲染之后”。在其他人工智能公司解释其爬虫的工作原理之前,这确实是一个值得遵循的建议。
翻译网站有两种方法。一种是服务器直接发送法语版本的页面;另一种是服务器发送英语版本的页面,然后在页面到达浏览器后,由脚本将文字进行替换。
对访问者来说,这两个页面看起来完全一样。但对于不运行脚本的爬虫来说,它只能看到第一个页面。
这个测试很容易自己操作;无需任何工具,只需10秒钟。打开法语页面,右键点击,然后选择“查看页面源代码”。如果源代码中没有法语文本,那么不运行脚本的爬虫也无法看到它。
这些数据让我感到意外。我测量的页面中位数在不加载脚本的情况下,其文本内容已能呈现84.6%,因此所谓“多语言网站只是空壳”的说法并不成立。相反,严重的情况其实是集中出现的:大约每7个页面中就有1个呈现的文本内容不足30%,而电子商务和旅游网站的表现远逊于软件、媒体或机构类网站。
在Weglot的子域名、子目录和 WordPress 配置中,翻译是在服务器端进行的,因此内容会在页面源代码中写入,然后才呈现给访问者。在 WordPress 中,这意味着诸如 /fr/about/ 之类的语言 URL 会返回已翻译的内容,而无需在后台创建额外的页面。
唯一例外是Weglot的JavaScript 集成,该功能专为自定义配置而设,且存在已记录的取舍:这些翻译内容不会出现在页面源代码中。如果您重视 AI 可读性,建议使用子域名、子目录或与内容管理系统(CMS)的集成方案。
我查看了weglot.com 的法语主页作为参考:在任何脚本运行之前,该页面已有 97.6% 的文本和 17 个 hreflang 标签。
如果您的网站通过内容分发网络(CDN)或安全服务(如 Cloudflare)进行托管,该服务会在请求到达您的服务器之前对其进行检查,并可能屏蔽其视为威胁的任何访问者,包括机器人。它既能抵御攻击、加快网站速度,但也决定着哪些访问者会被拒之门外。
在我的研究中,11.6% 的受测网站向谷歌爬虫返回了正常页面,却向 AI 爬虫返回了错误信息,两者仅在机器人名称上有所不同。 在这11个案例中,有9个网站的robots.txt文件(该公开文件用于告知爬虫可访问的内容)竟允许了其安全服务正在拦截的那个爬虫访问。这11个网站中有8个是公共机构、大学或旅游局,而这些组织通常都希望自己的内容被爬取。
您的内容管理系统(CMS)、搜索控制台和分析工具都不会对此发出任何警告,因为该页面对您和谷歌来说都能正常加载。
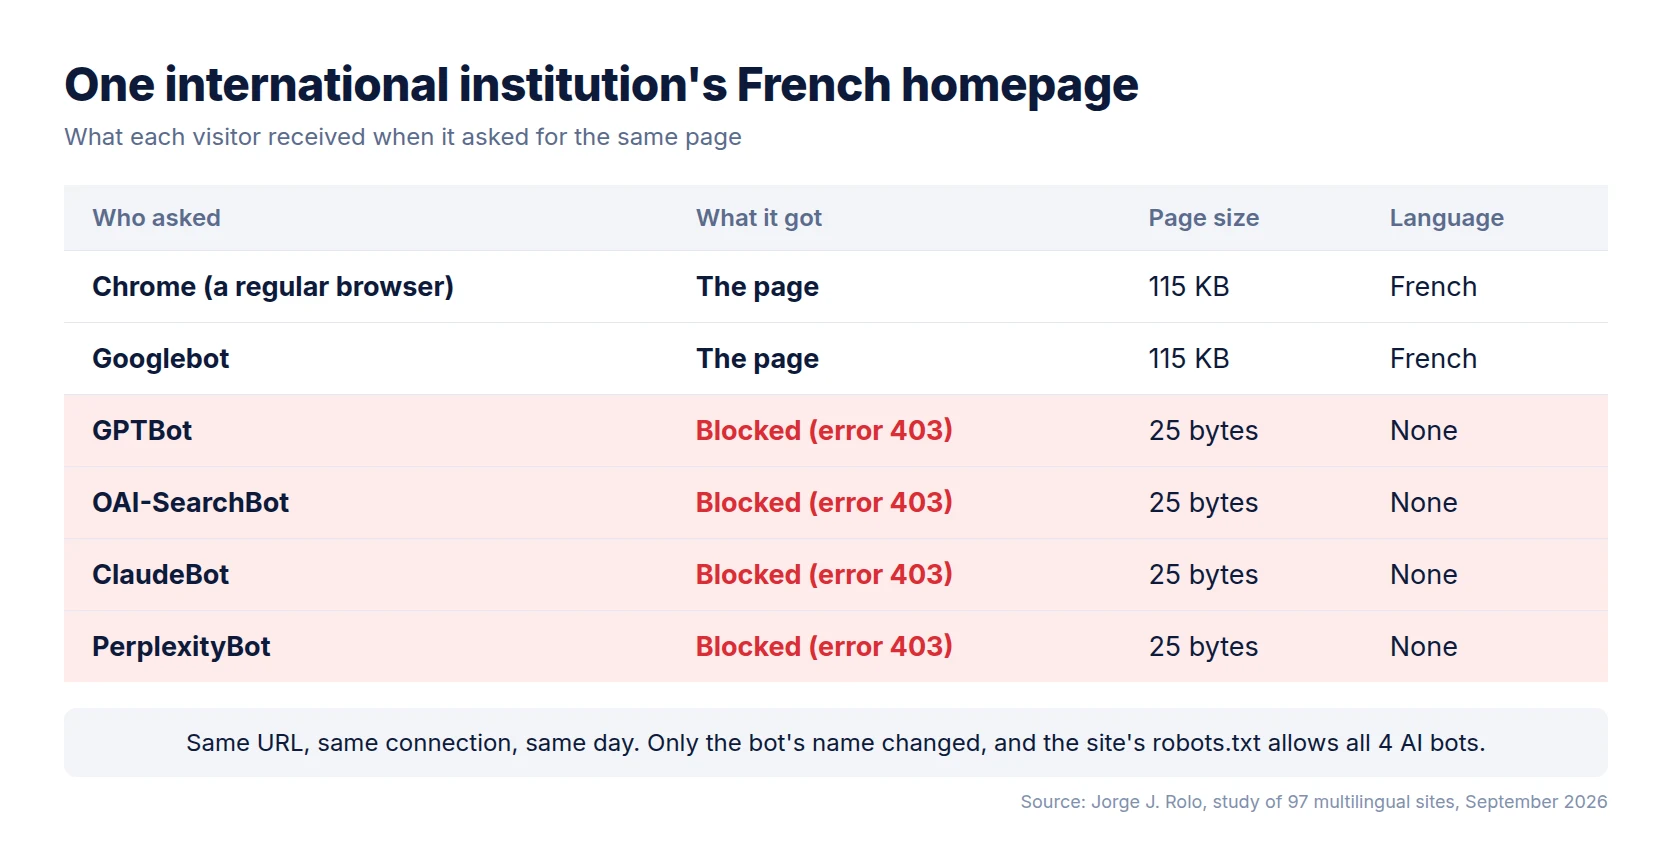
每家人工智能公司都会运行多个用于不同任务的机器人。OpenAI提供了用于训练的 GPTBot 和用于搜索的 OAI-SearchBot 的相关文档。
屏蔽 GPTBot 可以防止您的内容被用于未来的模型训练,但并不能让您的内容从 ChatGPT 的搜索结果中消失。屏蔽 OAI-SearchBot 则可以做到这一点,因此请检查您的 robots.txt 文件中列出了这两个机器人中的哪一个。
在我的样本中,27.7% 的网站在 robots.txt 文件中列出了至少 1 个 AI 机器人,11.7% 的网站在其语言页面上屏蔽了至少 1 个 AI 机器人,但没有网站屏蔽 Google 或 Bing。
您的法语页面即使完美无缺,也可能无法被访问,因为爬虫必须先找到它,而爬虫是通过追踪页面源代码中的链接来实现这一点的。
在我测量的语言版本中,有42.4%的情况是,从原始页面到翻译页面的唯一路径是hreflang标签——该标签用于告知搜索引擎哪一页是哪一页的法语版本。由于语言菜单是由脚本生成的,因此完全没有普通的链接。
这些网站之所以今天能正常运行,是因为它们的 hreflang 标签位于页面源代码中。但如果将这些标签移至脚本中——就像某些翻译插件在添加语言菜单时所做的那样——这些页面就会失去爬虫能够追踪到的唯一路径。在我的示例中,10 个翻译页面中有 4 个出现了这种情况。
Weglot 会自动将这些标签添加到您的页面中,无需任何人修改代码。其SEO 文档详细说明了在各种配置下该功能的工作原理。
有些网站会根据浏览器发送的设置来选择语言。只要该网站还添加了一行说明,写着“本页内容会根据访问者的语言而变化”,这种做法就可行。
如果没有这一功能,为了提高加载速度而缓存的页面副本可能会被直接提供给下一位访客,无论其使用何种语言。在我抽样的10个网站中,有10个会根据访客的语言动态调整页面内容,但其中只有1个网站明确提到了这一点。
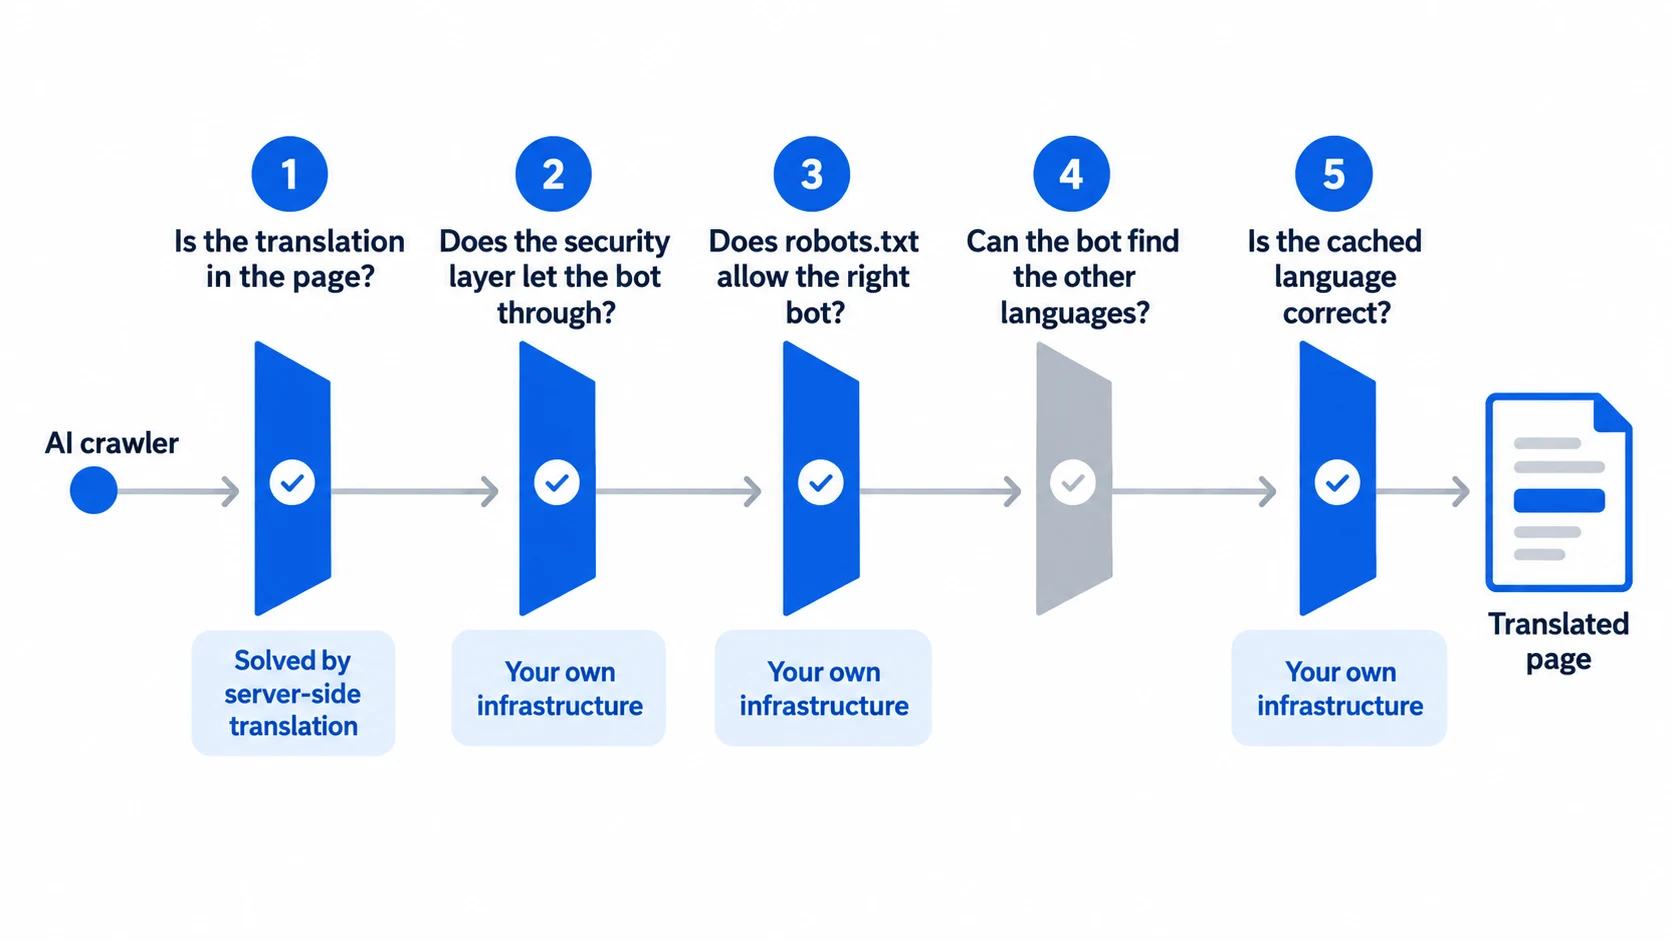
请按顺序执行以下操作:只有在前一步成功完成后,下一步才能执行。
Search Console 的“URL 检查”功能会显示 Google 渲染后的页面,而且 Google 会运行脚本,因此由脚本翻译的页面在该功能中看起来翻译得非常完美。它无法显示这个问题,这就是检查 1 存在的理由。
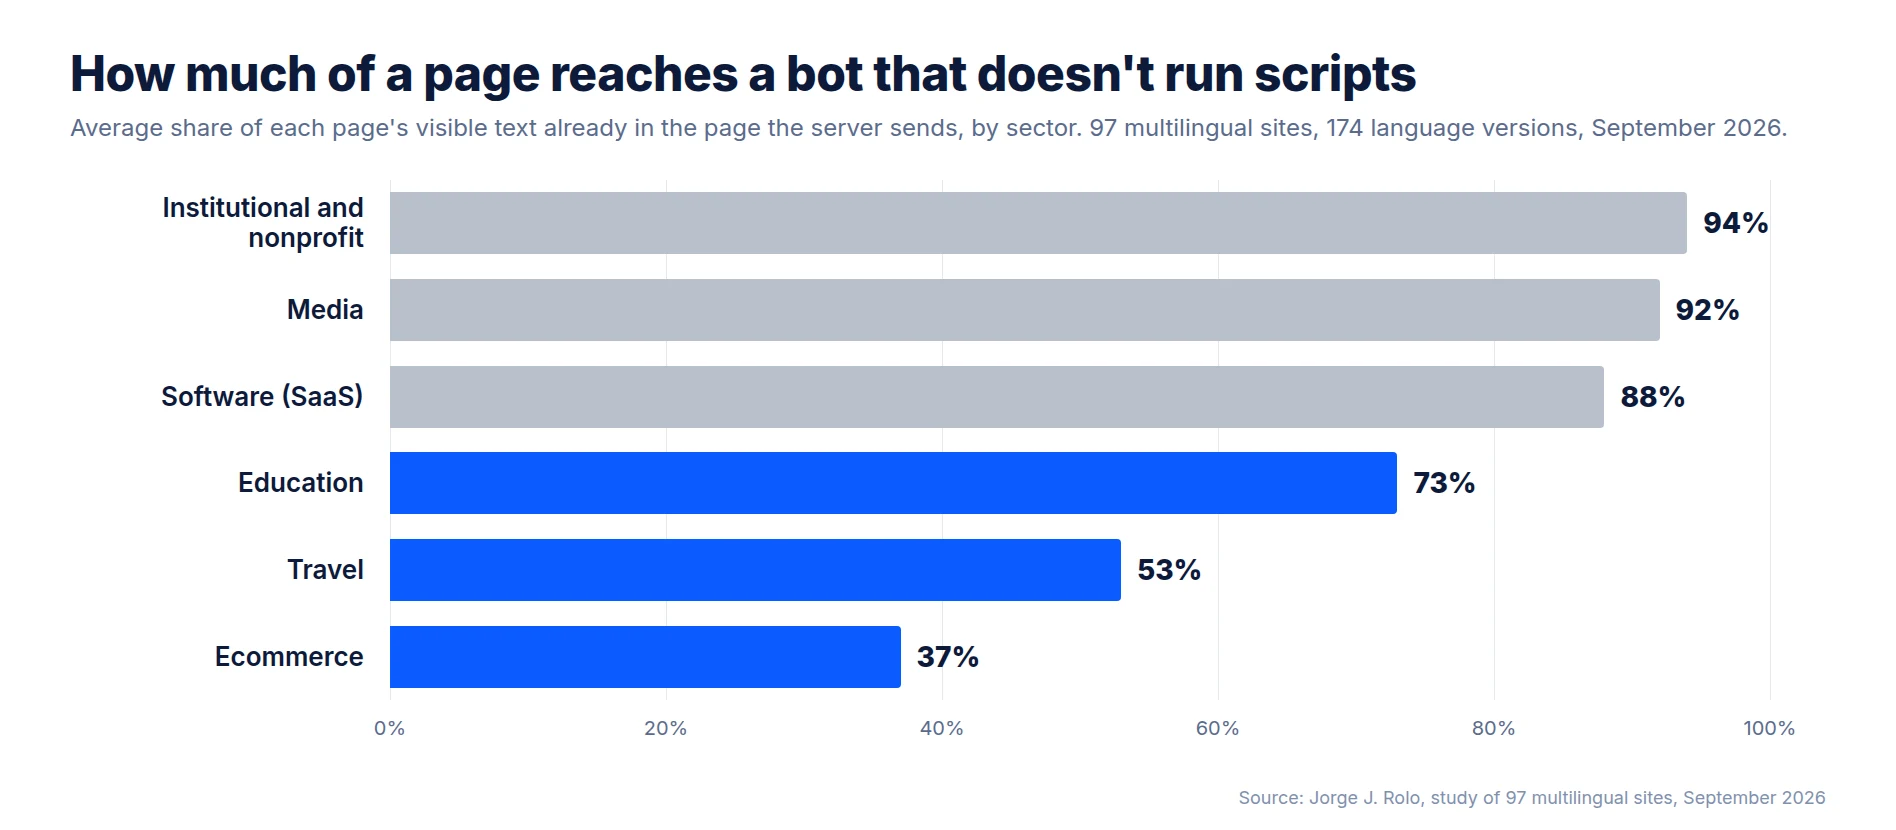
我考察了97个多语言网站和174个语言版本,涵盖软件、旅游、电子商务、媒体、教育、机构及非营利组织等领域的网站。
对于每个网站,我分别以两种方式各请求了所有页面两次:一次是以运行脚本的浏览器身份,另一次是以不运行脚本的爬虫身份。随后,我使用6个不同的爬虫名称发送了相同的请求,并检查了每个网站robots.txt文件中关于语言路径的规则。为避免偏见,在测试任何我不熟悉的网站之前,我都先记录下自己对该网站的分类方式并标注了时间戳。
这项研究有两个局限性。我的请求是通过普通网络连接发出的,而非来自人工智能公司自身的服务器,因此我测量的只是一个自称GPTBot的机器人所接收的内容,这可能与真正的GPTBot所接收的内容有所不同。此外,我测量的是爬虫所获取的内容,而非人工智能助手引用这些网站的频率。后者需要另行开展专门的研究。
如果你本周只做一件事,那就查看你最重要的翻译页面的源代码。如果源代码中没有翻译后的文本,你就找到了答案——解决方法是让服务器而非浏览器提供翻译内容。
如果存在该问题,请转到第2层,因为我就是在那里发现了标准检查无法发现的故障。
“被翻译”和“可读”并非一回事,但只需一个下午,你就能衡量两者之间的差距。
确保AI爬虫能够读取您发布的每种语言的内容。根据我的研究,大约每7个翻译页面中就有1个,其提供给不运行脚本的爬虫的文本内容少于30%。通过Weglot的子域名、子目录和WordPress配置,您的翻译内容将由服务器直接提供,并自动添加hreflang标签,因此从首次请求开始,所有语言版本都会出现在页面源代码中。立即开始您的14天免费试用,然后对您自己的翻译页面运行检查1。

我们将让您的首选语言实时上线。您决定要走多远。立即Weglot 试用Weglot 。
已获得全球110,000+个品牌的信赖



自2016年以来Weglot 全球众多品牌的测试并赢得了他们的信赖。今天就加入他们吧。


要了解Weglot 的强大功能,最好的方式就是亲自体验一下。您可以免费试用,且无需承担任何义务。
如果您尚未准备好连接自己的网站,可以在控制面板中使用演示网站。


